単純なキーワード一致だけでなく、自然言語処理技術によって検索意図や文脈を理解する「意味的検索」を実現します。100万社分のデータを学習した独自モデルにより、曖昧な入力からでも最適な情報へ辿り着ける高精度なマッチングを支援します。
お客様の抱える課題
従来型のキーワード検索システムでは、情報の増加に伴い以下のような課題が顕在化しています。
キーワード依存による情報の埋没
特定の正確なキーワードを知らなければ適切な情報に辿り着けず、情報の検索性が著しく低下しています。これにより、必要な知見やドキュメントが社内にあっても活用されない状況が生じています。
検索意図・文脈の無視
文字列の完全一致のみを判断基準とするため、ユーザーがどのような背景や意図で検索しているかという「意味」を汲み取ることができず、ノイズの多い検索結果や非効率な情報収集を強いています。
解決アプローチ
自然言語処理(NLP)技術を駆使し、広範囲で精度の高い情報検索・マッチング基盤を構築します。
100万社規模の企業データに基づく用語モデル構築
100万社分の事業概要文という膨大なテキスト資産を活用し、ビジネスや企業活動に関する用語の繋がりや文脈を深く学習。一般的な辞書では対応できない専門的なドメイン知識を備えた用語モデルを構築します。
情報のベクトル化と分散表現の実現
構築したモデルを基礎として、あらゆるテキスト情報を多次元のベクトルデータとして数値化します。これにより、単語や文章の「意味の近さ」を数学的に計算することが可能になり、文脈レベルでの高度な検索を実現します。
検討のプロセス
単なるシステムの導入ではなく、ビジネスの実態に即した検索ロジックの構築プロセスを経ます。
ドメイン特化型モデルによる学習の最適化
汎用的なAIモデルではなく、実際の事業概要文から学習を行うことで、業界特有の用語や言い回しの「意味」を正確に捉えるモデルを生成します。
意味的類似性に基づくマッチングロジックの確立
情報の分散表現(ベクトル化)を用いることで、言葉の揺らぎや類義語を自動的に吸収。ユーザーの入力に対して、意味的に関連性の高い情報を広範囲から抽出するマッチングエンジンを実装します。
創出価値
「意味」を理解する検索の導入により、情報資産の活用効率を最大化します。
検索意図の補完とセルフサービス化の促進
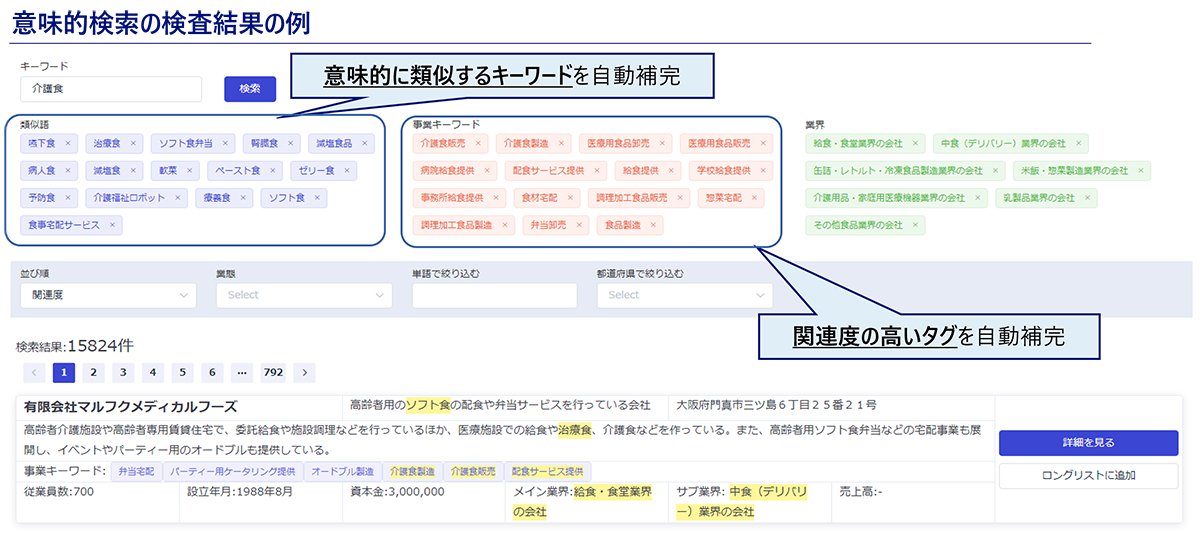
ユーザーの曖昧な検索意図をAIが補完し、最適な関連語をリコメンド。専門知識が乏しいユーザーでも、迷うことなく目的の情報に辿り着ける環境を提供します。
文脈考慮による検索精度の劇的向上
文脈や意味の重なりを考慮した「意味的検索」により、従来のキーワード検索では不可能だった高精度なマッチングが可能に。情報検索にかかる時間を大幅に短縮し、業務の生産性を高めます。
自動タグ補完によるデータ管理の高度化
検索結果の例にもあるように、関連度の高いタグを自動的に補完・付与することで、膨大なデータの分類や整理の自動化、情報の構造化を強力に支援します。