1. 地域の関心喚起と「順位指標」の役割
このような都道府県別順位の提示は、自治体や地域金融機関をはじめとする関係者の関心を喚起し、金融経済教育の推進活動を促すインセンティブとして一定の役割を果たしている。地域における取り組みの必要性を認識させ、関係機関の連携を主導するうえで、明確な数値指標が提示されることの有用性は認められる。
2. 単年順位が変動する統計的構造
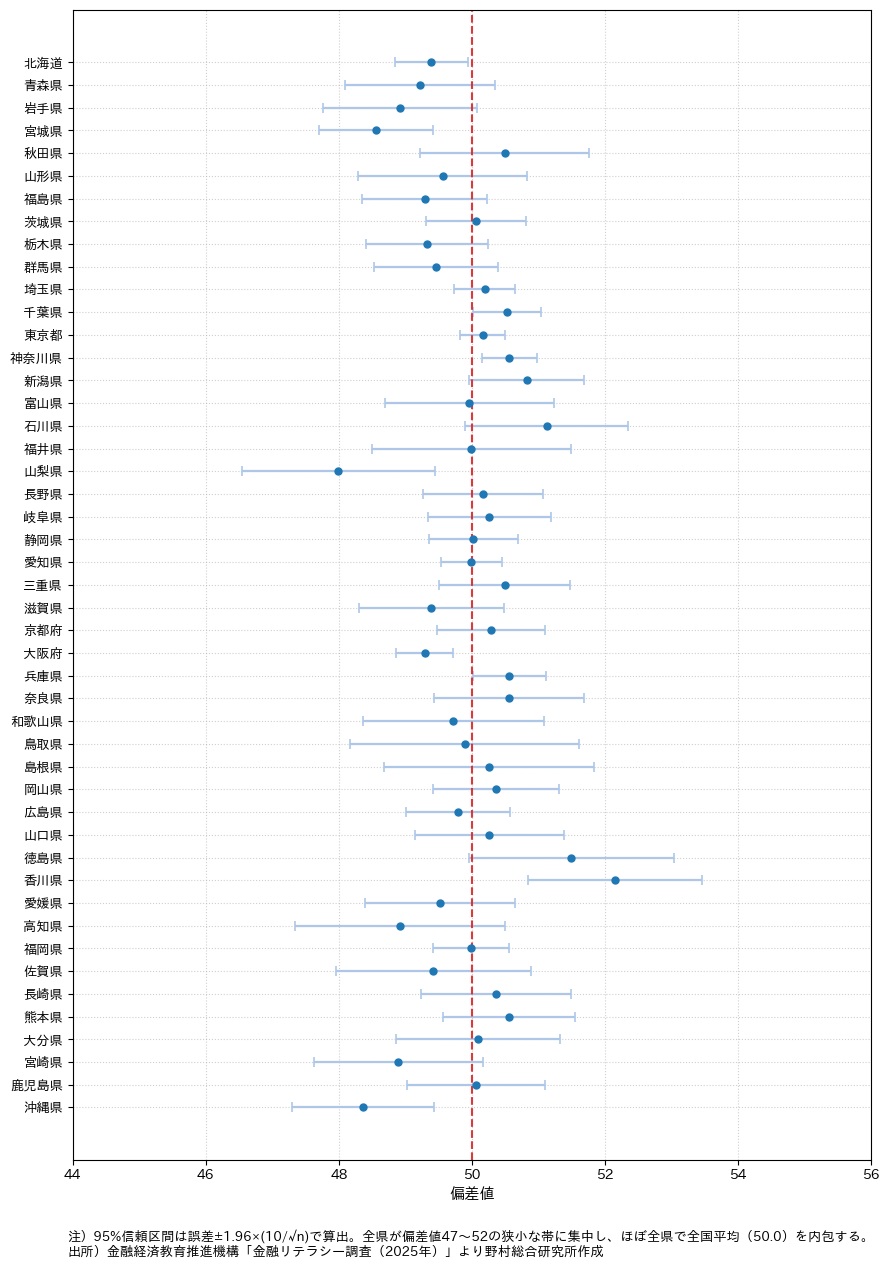
第1に、「都道府県間における平均値の差の小ささ」である。図表1(都道府県別金融リテラシー偏差値(注)と95%信頼区間)に示す通り、2025年調査における全47都道府県の偏差値は48.0(山梨県)~52.1(香川県)の範囲内に収まっている。正答率に換算すると最小47.8%から最大60.3%(全国平均53.8%)の開きがあるものの、大部分の自治体は平均周辺のきわめて狭い領域に集中している。
第2に、「標本サイズに由来する標準誤差」である。本調査の有効回答数は全国で2.5万~3万人(2016・2019年は2.5万人、2022・2025年は3万人)であり、人口規模の小さい都道府県では1自治体あたりの標本サイズが130~300人程度となる。この場合、都道府県平均値の95%信頼区間幅は偏差値換算で±1.1~±1.7ポイント程度生じる。
図表1の通り、全47都府県中39都府県(約8割)において信頼区間が全国平均線(50.0)を包含しており、統計的に全国平均と有意な差が認められる自治体は8県と限定的である。このように、統計上「真の実力に有意な差がない(同等とみなせる)」多数の自治体が平均値周辺の僅かな幅の中に密集しているため、標本抽出に伴う偶然の誤差によって正答率がわずかに前後するだけで、順位が10~30位程度容易に逆転・変動する構造となっている。したがって、単年における順位の短期的変動を実力の変化として過大に評価することは適当ではない。
3. 統計的ノイズと持続的シグナルの識別
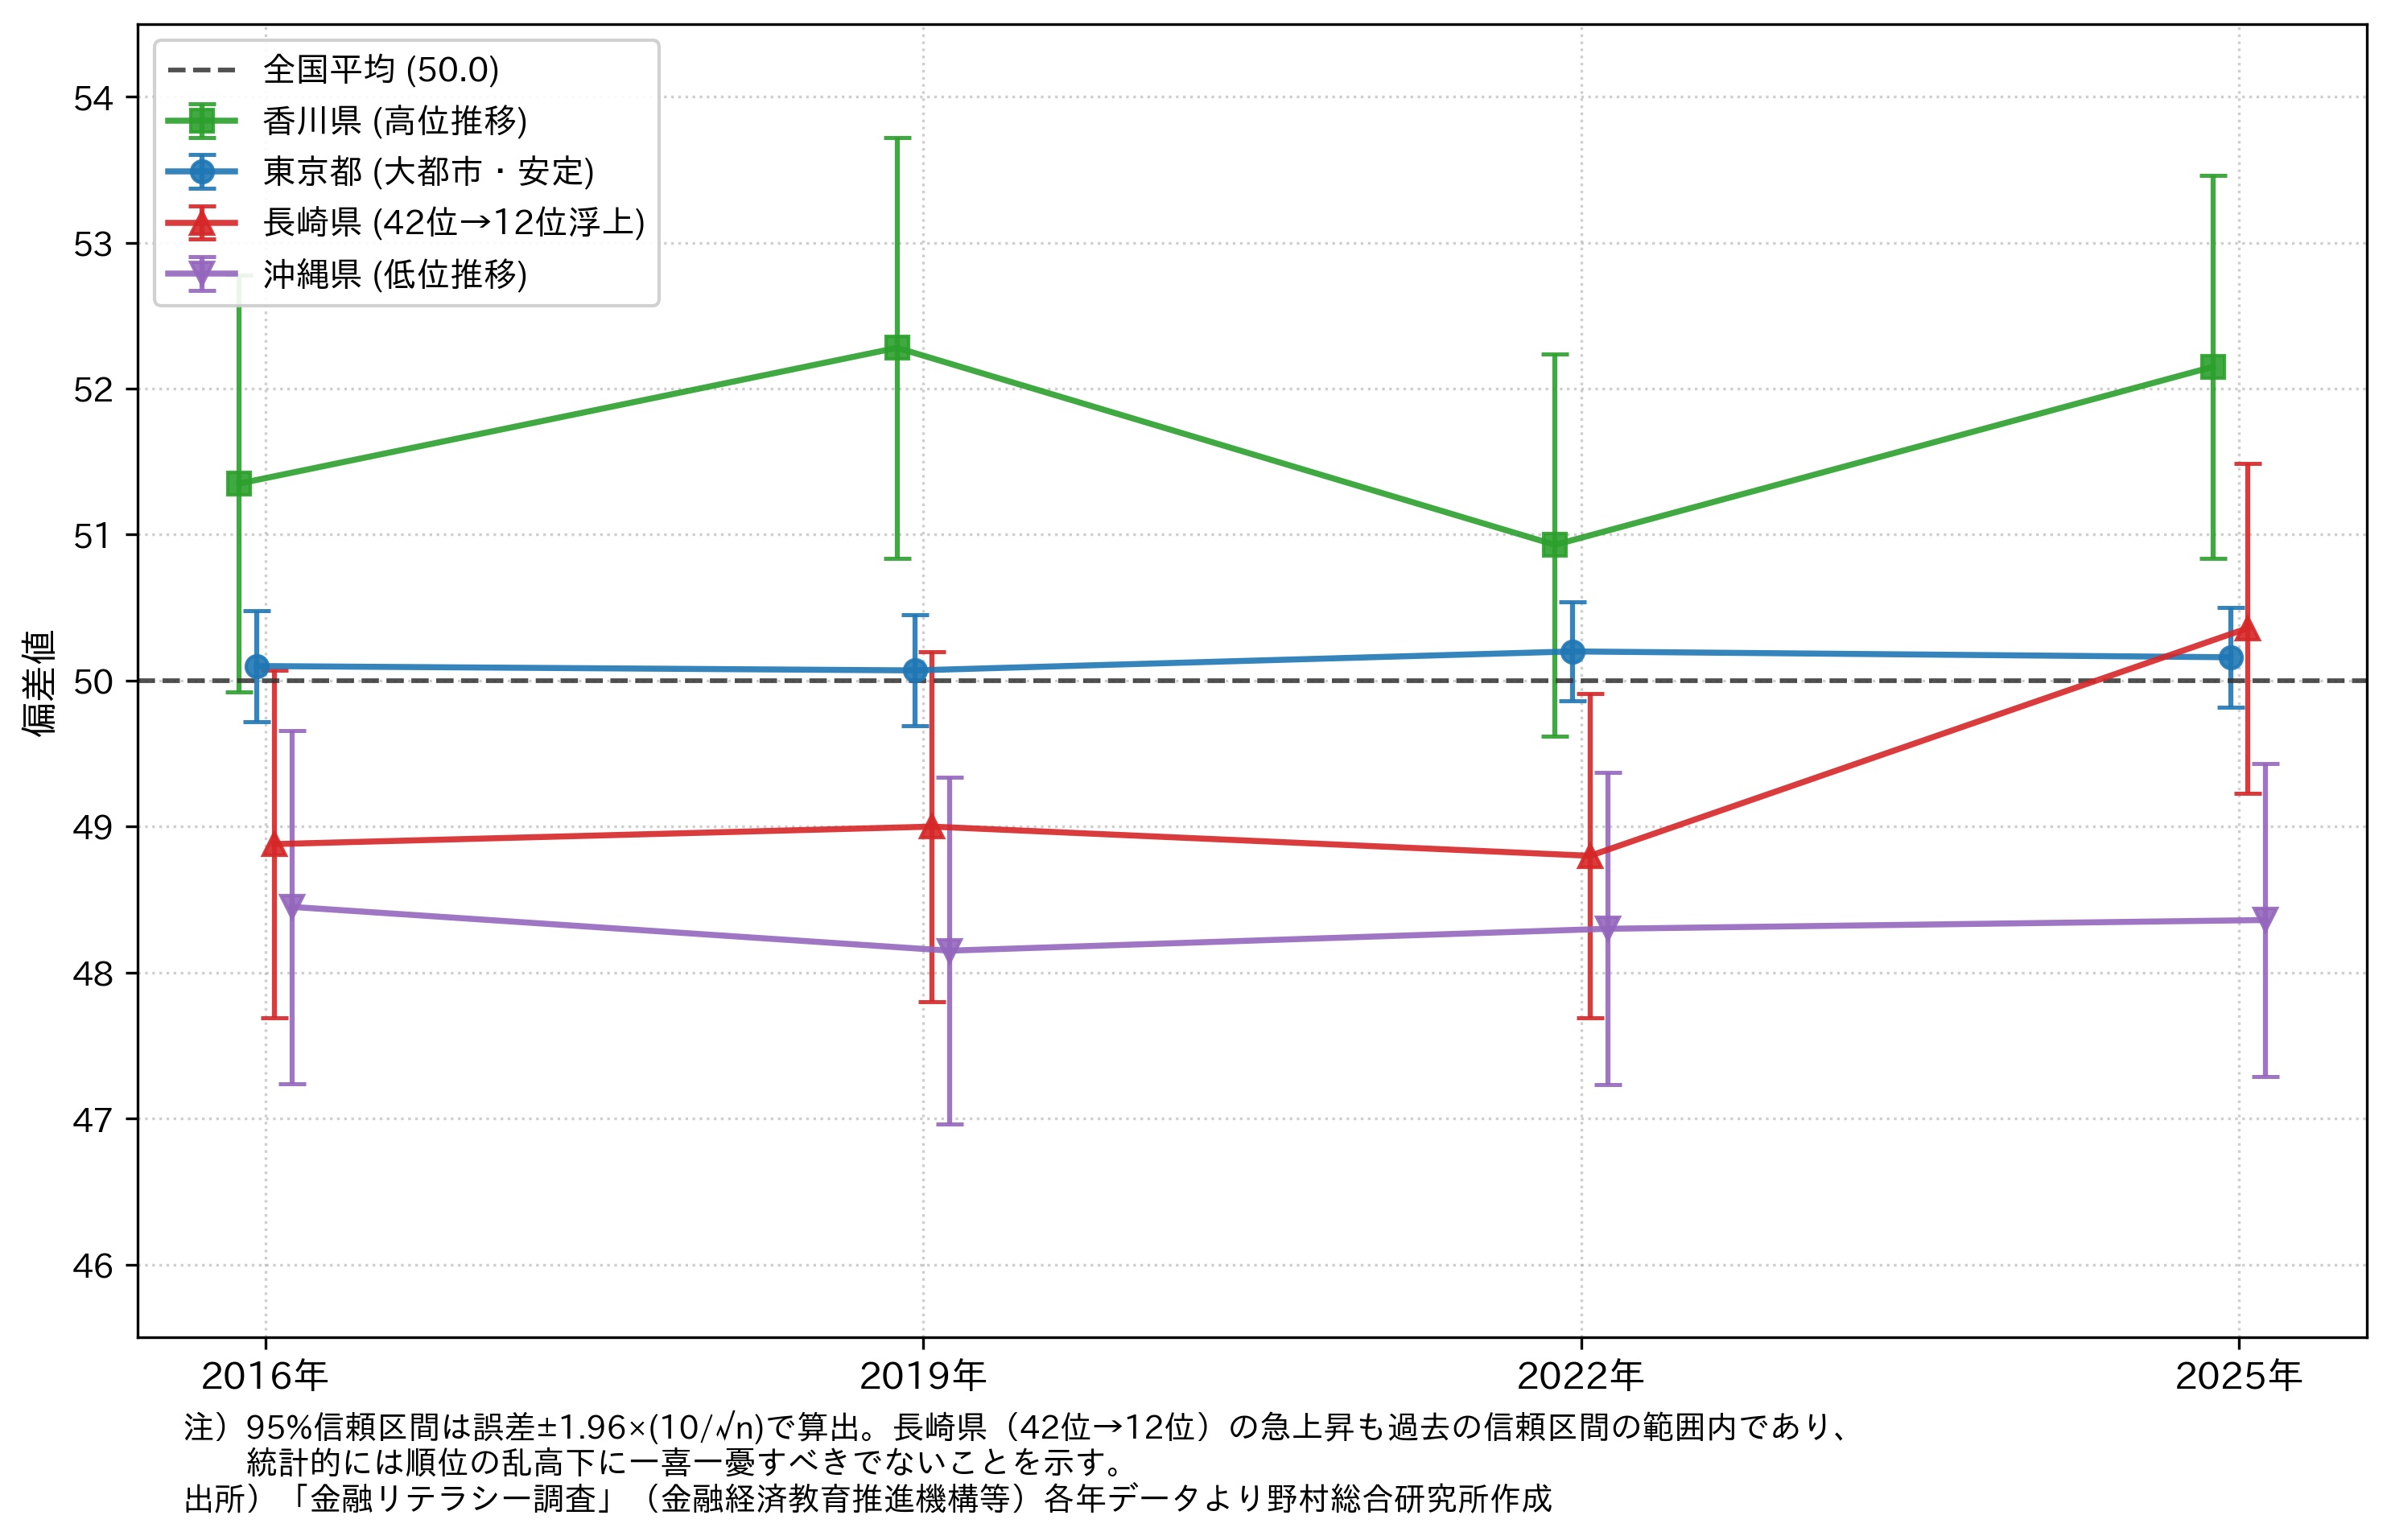
図表2(特徴的な都道府県における偏差値と95%信頼区間の推移)は、特徴的な推移を示す4県の過去4回(2016年~2025年)のデータを算出したものである。前述の長崎県(赤線)の推移を見ると、2025年調査の推定値は上昇しているものの、その信頼区間は過去の調査における信頼区間と大きく重複していることがわかる。これに対し、香川県のように複数年にわたり信頼区間の下限が全国平均(50.0)を上回る水準で推移している地域や、沖縄県のように一貫して50.0を下回る水準を維持している地域も認められる。
このように複数期間にわたって一貫した差異が観察される傾向は、サンプリング誤差ではなく、地域の人口高齢化率、所得・資産階層の構成比、金融関心度といった社会経済的属性(背景因子)の違いを反映した統計的シグナルと解釈できる。ただし、こうした有意差が観察されるケースにおいても、正答率の絶対的な差は数ポイント程度にとどまり、実質的な水準差は僅微であることに留意する必要がある。
4. 施策評価における絶対評価の重要性
金融リテラシー向上の主目的は、地域間でのスコア競走ではなく、個人の経済的自立や生活の安定に寄与することにある。数値指標の背後にある統計的構造や誤差の性質を客観的に見極め、持続的かつ効果的な教育施策を展開することが重要である。
【参考資料】公表集計データに基づく都道府県別偏差値および信頼区間の算出手法
本コラムにおける都道府県別の分析では、個票データ(個人単位のミクロデータ)を用いず、公表されている集計データ(報告書等の統計表)のみから各都道府県の偏差値および信頼区間を算出している。統計的推計の手順および根拠は以下の通りである。
1. 偏差値(Tスコア)への標準化
都道府県 k の公表平均正答率を xk、全国平均正答率を x、個人回答データの全国標準偏差を SDx とするとき、都道府県 k の偏差値 Tk は以下の変換式により算出できる。
本変換により、調査年ごとの平均値や問題難易度の違いが標準化され、平均50・標準偏差10の同一尺度上で時系列比較が可能となる。
2. 標準誤差および95%信頼区間の算出
Tスコア尺度上における個人の標準偏差は定義により SDT = 10 である。都道府県 k の有効回答数を nk とすると、都道府県平均Tスコアの標準誤差(Standard Error: SE)および95%信頼区間(Confidence Interval: CI)は以下の通り導出される。
3. 都道府県別の分散(標準偏差)を考慮不要とする理由(等分散性の成立)
本来、標本平均の標準誤差の厳密な算出には都道府県ごとの回答の分散(標準偏差)が必要となる。しかし本分析では、以下の統計的性質に基づき、個別の分散を考慮せず全国共通の標準偏差(SDT = 10)を一律適用している。
- 正答率分散の安定性(等分散性): 二項分布における分散は p(1 − p) で定義される。全47都道府県の正答率 pk は47.8%~60.3%(0.478~0.603)の狭い範囲に集中しており、分散値は0.2394~0.2495とほぼ一定(最大差でも数%以内)である。
- Tスコア尺度での標準偏差の近似: 上記の等分散性により、Tスコア尺度上の都道府県別標準偏差 SDT,k も全国共通の数値(SDT = 10)ときわめて近く(SDT,k ≈ 10)、一律10とみなしても実用上十分な精度が確保される。
4. 本手法の適用条件と実務上のメリット
- 必要データ: 「全国平均」「全国標準偏差」「各都道府県の平均値」「各都道府県のサンプル数(nk)」の4項目(すべて公表報告書の集計表から取得可能)。
- 実務上のメリット: 個票データの二次利用申請や開示を待つことなく、公表集計表のみから迅速かつ客観的に各自治体の位置づけと標本誤差の範囲を算出し、可視化することが可能である。
(注)都道府県別の比較では正誤問題の「正答率(%)」が用いられることが多いが、本分析では各調査年の全体平均や分散の違いを標準化し時系列での比較を可能とするため、正答率を「偏差値(Tスコア)」に換算した指標を用いている。
プロフィール
-
金子 久のポートレート 金子 久
金融イノベーション研究部
1988年入社、システムサイエンス部及び投資調査部にて株式の定量分析を担当。1995年より投資情報サービスの企画及び営業を担当。2000年より投資信託の評価やマーケット分析のためのデータベース構築、日本の資産運用ビジネスに関する調査、個人向け資産形成支援税制、投信に関する規制などを担当。その間2005年から1年間、野村ホールディングス経営企画部に出向し、アセットマネジメント部門の販路政策などを担当。
※組織名、職名は現在と異なる場合があります。